深度解析医学证据,lxfs.net为你支撑决策
目标:通过脓毒症预测模型的案例研究,介绍一种新颖且标准化的方法,用于在有效性、效率和实用性之间评估人工智能预测模型。
材料与方法:利用7家公立医院电子病历中的回顾性患者数据,对一种机器学习脓毒症预测模型进行重新训练和评估。将四种传统指标——受试者工作特征曲线下面积(AUROC)、敏感性、阳性预测值和特异性,与一种新型图形化展示方式进行了比较。该图形化展示整合了不同预警阈值下的预测准确性(有效性)、预警负担(效率)以及预警相对于临床事件的提前时间(实用性)等指标。
结果:该数据集包含977,506例住院病例。新的方法生成了四幅垂直排列的图表,使决策者能够确定一个警报阈值,以在整体住院层面实现效果、效率和效
用(EEU)的最佳平衡,且该阈值与使用传统指标得出的结果不同。传统的评估指标未考虑警报时机与临床事件之间的关系,且常应用于不同的评估数据集(样本级和入院级),从而引入偏差和混淆。相比之下,EEU方法论(i)可在不同警报阈值下生成入院级评估;(ii)测量警报时机相对于临床事件的时间关系;(iii)提供可视化展示,有助于识别在各项EEU因素之间实现最佳平衡的警报阈值。
结论:在评估住院患者不良事件预测模型时,应采用EEU方法来判断模型的适用性并选择预警阈值。
一、引言
基于人工智能(AI)的模型利用医院中的实时患者监测数据,预测败血症或临床恶化等不良事件的发生,目前已得到广泛研究,其中一些模型已在临床实践中广泛应用。然而,这些模型在实际部署后,对患者护理的改善效果参差不齐,甚至毫无提升,其原因往往未被充分探究。部分问题可能源于输出端的不足,例如模型未能有效融入临床工作流程、医护人员培训不足或对模型输出反应不佳。此外,临床医生也可能因以下原因而不采用这些模型:(i)模型无法有效识别有不良事件风险的患者;(ii)在资源和医护人员时间使用方面效率低下;(iii)相较于现有方法,模型对改善医疗护理的实际帮助有限。在实施前评估有效性、效率和效用(以下简称EEU因素)对于任何预测模型而言,都是优化用户接受度的关键,这一点在技术接受模型(TAM)和统一技术接受与使用理论(UTAUT)中均有体现。
在实施前,人工智能预测模型通常会根据TRIPODAI11等报告指南,采用静态数据集进行回顾性评估,并利用动态实时数据流进行前瞻性评估。在两项近期关于已实施的脓毒症和病情恶化预测模型的系统综述中,最常引用的性能指标包括:(i)判别统计量:受试者工作特征曲线下面积(AUROC)和精确率-召回率曲线下面积(AUPRC);以及(ii)依赖于预警阈值的操作指标:敏感性、阳性预测值(PPV)、首次预警与不良事件发生之间的中位时间(MTBFAA),以及每日平均预警次数的变体。
这些指标对应一个或多个EEU因素(见表1),用于在不同模型之间进行选择,并确定最佳的警报阈值,即AI模型输出概率超过该阈值时触发警报。然而,这两项功能均存在明显缺陷。首先,MTBFAA作为临床医生实用性的衡量指标效果较差,因为如果警报在临床医生已怀疑或已对预测事件作出反应后才到达,则其作用微乎其微甚至毫无价值。以脓毒症为例,若警报在患者出现器官功能障碍(即符合Sepsis-3标准13)前3小时发出,但此时临床医生已在2小时前开始使用抗生素,则该警报几乎无实际意义。其次,AUROC和AUPRC均未考虑警报时机问题,例如,模型A与模型B的AUROC相同,但模型A发出的警报平均比模型B晚4小时,而此时临床医生可能早已识别出相关事件。第三,现有指标均未同时考虑全部三个EEU因素,这阻碍了临床医生及其他决策者选择最优化的模型和警报阈值,以在保证可接受敏感性的同时避免警报疲劳(即阳性预测值低),并确保首次警报通常出现在临床医生怀疑或确认事件之前。决策曲线分析(DCA)曾被用于确定特定模型的概率输出阈值,当超过该阈值时,临床干预可能带来益处;但该方法基于静态、回顾性的模型评估,未考虑在动态实时数据输入中警报时间与其他临床事件之间的关系。此外,DCA对临床医生而言也较难理解与解读。这些传统的性能指标彼此不同,但在比较这些指标时,其权衡关系可能十分复杂,无法为特定临床环境下的模型适用性或警报阈值提供明确的最优选择。在设计一项针对全州医院网络的基于人工智能的脓毒症预测模型实时前瞻性无干扰评估时,发现了上述局限性。为此,需要与临床终端用户合作,开发一种全新的评估流程,将各项EEU因素整合起来,以便在评估模型适用性和选择最佳警报阈值时,能够清晰地理解各因素之间的权衡关系。
二、目标
以脓毒症预测模型为案例研究,开发一种新颖且标准化的方法论,用于评估和平衡伦理、公平性与实用性(EEU)因素,使决策者能够(i)判断人工智能模型是否适用于临床实践,以及(ii)为其选择最佳的预警阈值。
三、背景与意义
其他研究人员已认识到仅使用AUROC或AUPRC的局限性,并在模型评估中纳入了部分但非全部EEU权衡因素。例如,针对脓毒症预测模型,Wong等人评估了Epic脓毒症模型(ESM),并绘制了相对于脓毒症事件发生时间的三个不同时间点上的AUROC、敏感性和特异性,以探究模型效能随时间的变化情况。Topiwala等人考虑了临床实用性,将其定义为工具既能正确发出警报,又能在临床怀疑出现之前发出警报(依据临床记录中的笔记内容),且这两个指标是独立计算的。同样,Giannini等人报告的是抗生素给药的时间,而不仅仅是预测脓毒症事件的时间。Kamran等人则基于警报在多种临床操作前到达的情况重新评估了AUROC,试图理解模型性能与实用性的权衡关系。最后,尽管Brown等人尝试通过绘制多个警报阈值下的敏感性、特异性、阳性预测值和假阳性率来选择最佳警报阈值,但未考虑警报时机问题,因此无法同时评估其实际效用。类似局限性也适用于针对其他非脓毒症事件(如新冠肺炎、心脏骤停和临床恶化)的已实施模型预测研究。
一种为医院提供透明且综合方法来评估人工智能模型在有效性、效率和实用性方面的适用性,并通过警报阈值对这些因素进行标准化权衡的方法,可防止不合适的模型被实施,促进临床医生更好地采纳,并提升已实施模型的效益。
表1.影响基于人工智能的监测预测模型向医疗改善转化的因素(第1列)、相应的依赖于警报阈值的人工智能评估指标(第2列),以及受试者工作特征曲线下面积(AUROC)与精确率-召回率曲线下面积(AUPRC)(第3、4列)与上述因素及依赖于警报阈值的指标之间的关系。
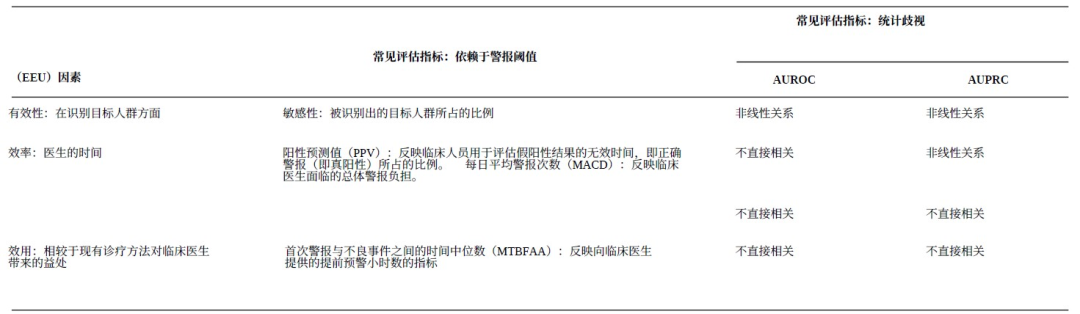
EEU:有效性、效率和效用。
表2.脓毒症-3定义。
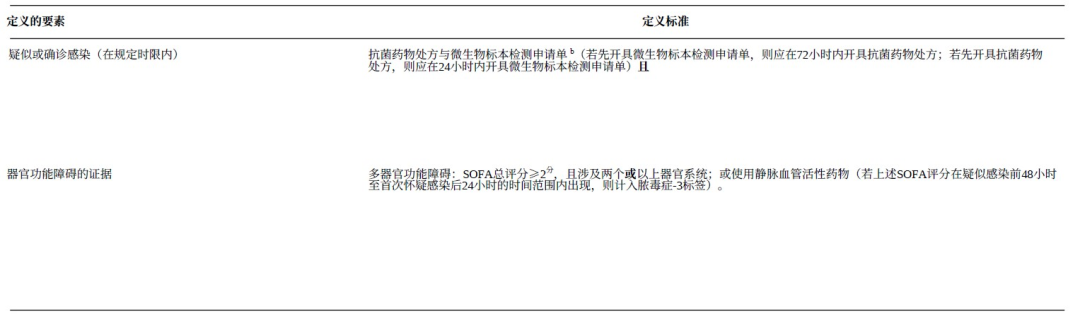
四、材料与方法
本节分为两部分:(i)案例研究设置,描述用于训练和评估AI模型的回顾性患者数据集,以及数据集准备、特征变量和模型配置的简要概述;(ii)详细说明新方法论的推导过程,并将其与传统指标进行比较,以评估模型性能及选择临床最优的警报阈值。
案例研究设置
参与者与背景
患者数据来自2021年1月1日至2024年12月31日期间,澳大利亚昆士兰卫生公共医院系统内7家数字化医院(3家三级医院,4家二级医院;5家大都市医院,2家地区性医院)的成人住院患者。排除了未在急诊科(ED)就诊或未住院,以及缺少至少一次心率、收缩压和血氧饱和度记录的病例。由于本研究关注的是急诊科或普通病房患者,因此在患者层面,我们还排除了重症监护室(ICU)、手术室和麻醉后护理单元中接受密切监测的医疗事件相关数据。研究报告遵循了基于人工智能模型预测研究的TRIPOD+AI指南。
AI模型、变量及数据集准备
我们改进了先前研究中开发并描述的开源轻量级梯度提升机器学习模型(LightGBM)31。该模型共使用了40个变量作为66个特征,缺失值采用前向填充法进行填补,首次数据录入前出现的缺失值则赋予空值(详见补充附录2)。
根据先前的研究,16个选定的特征被划分为每个住院期间的累积(平均)小时时间间隔(称为样本),从患者首次记录的测量值开始,到可用数据的最后个小时结束。这些一小时的时间间隔反映了临床专家委员会确定的模型部署更新(或刷新)频率。对于每个小时样本,均分配一个二进制标志:若在该小时或之后满足脓毒症-3标准,则设为真,否则设为假。所有纳入的住院患者的样本数据集被划分为训练集和测试集。训练集包含2021年1月1日至2023年12月31日期间所有患者住院的样本,测试集则包含2024日历年其余所有患者住院的样本。在模型训练过程中,一旦满足Sepsis-3标准,所有小时级样本即被移除。
模型训练与评估
模型在训练数据集上采用五折交叉验证进行训练,超参数优化也使用了相同的过程。在交叉验证中确定的最佳模型被用于测试数据集的最终外部评估和警报阈值选择。为了便于比较,我们报告了两组结果:传统方法和新方法,如下所示。
常规评估与预警阈值选择
我们记录了近期一项系统综述中确定的六种已实施的基于人工智能的脓毒症预测工具的回顾性和前瞻性模型评估指标:Epic脓毒症模型、InSight、SepsisWatch、TrewScore、Sepsis Sniffer以及其他。当至少有两项研究报告了某一特定指标时,我们将其纳入常规评估;这些指标包括固定警报阈值下的指标(敏感性、特异性、阳性预测值、首次误报前平均时间)以及所有阈值下的指标(AUC-ROC)。所选择的固定警报阈值对应于报告的中位敏感性0.8(范围0.75–0.86)。我们还从研究中识别出两种不同的评估数据集配置:样本级(明确说明,或在未提及数据集整合方法时假设为)和入院级。以图1中的示例为例,样本级数据集(即每小时样本、测试数据集)包含每个患者入院期间模型生成的所有预测样本,涵盖所有患者入院情况。入院水平的数据集(以下简称“Testadm”)通过在每位患者的每次入院中选择一个样本进行汇总,通常选择模型评分最高的样本,例如图1中模型输出为0.7的“样本10”。
新型模型评估及预警阈值选择方案
在第一步中,我们使用样本级别的测试数据集,在阈值范围(0到1)内以0.02为步长生成模型的精确率-召回率曲线(PR曲线),该曲线绘制了阳性预测值(PPV)与敏感性之间的关系。
在第二步中,将样本级别的PR曲线转换为一个新的图表,该图表绘制了入院级别指标:阳性预测值(PPV)、敏感性和被预警的患者入院比例。为此,我们从样本级别数据集中构建了一个入院级别数据集,并对第一步中样本级别PR曲线所使用的每个阈值评估相应的指标。对于每个阈值,构建对应的入院级别数据集时,针对每次入院选择第一个模型输出达到或超过该阈值的小时样本;若无任何输出超过该阈值,则随机选取一个样本(详见补充附录5中的详细方法)。
在第3步中,将第2步中每个阈值下生成的真阳性样本与现实临床操作相关联,方法是报告从首次脓毒症警报到特定或治疗措施之间的时间间隔,这些措施表明临床医生已意识到或怀疑存在脓毒症。临床专家委员会确定了3项临床事件:(i)开具相关的微生物学检测;(ii)使用抗生素;以及(iii)由现有基于规则的昆士兰成人病情恶化预警系统(Q-ADDS)评分达到4分所触发的患者评估,该系统是一种类似于国家早期预警评分(NEWS)的病情恶化检测工具。针对相同的阈值和与第2步图表一致的横轴(样本水平敏感度),绘制出从首次警报到(i)、(ii)、(i或ii)、(iii)以及到首次满足脓毒症-3标准的
时间中位数。同样,生成一个新的图表,用于显示首次警报发生在上述相同临床事件之前的占比。
在第4步中,上述四个图表按垂直方向排列,并采用相同的x轴刻度。随后,临床专家委员会被要求就一条贯穿所有四个图表的垂直线达成共识,以确定一个警报阈值,在该阈值下,他们认为入院水平敏感性、阳性预测值(PPV)、被发出警报的患者比例以及在三种临床事件发生前的警报中位时间之间达到了最佳平衡。决策过程可达成共识,若无法达成共识,则由最终委员会主席(IAS)做出决定。
五、结果
患者特征
在2,012,304次原始入院记录中,排除了994,232例未在急诊科或病房停留(即日间患者)以及16,726例无生命体征(心率、收缩压、血氧饱和度)的病例,最终保留977,506例入院记录用于分析,共包含38,688,058条每小时数据样本(见表3)。
常规的度量评估
使用传统指标对测试数据集进行模型评估的结果,包括样本级别和入院级别的报告,见表4的第1列和第2列。当以入院级别与样本级别报告时,结果存在显著差异(见图2),包括AUROC提高13%,特异性提高37%,首次预警至首次满足Sepsis-3标准的中位时间减少63%。而敏感性和阳性预测值(PPV)在两组之间的差异仍控制在2个百分点以内。各医疗机构的具体结果详见补充附录6。
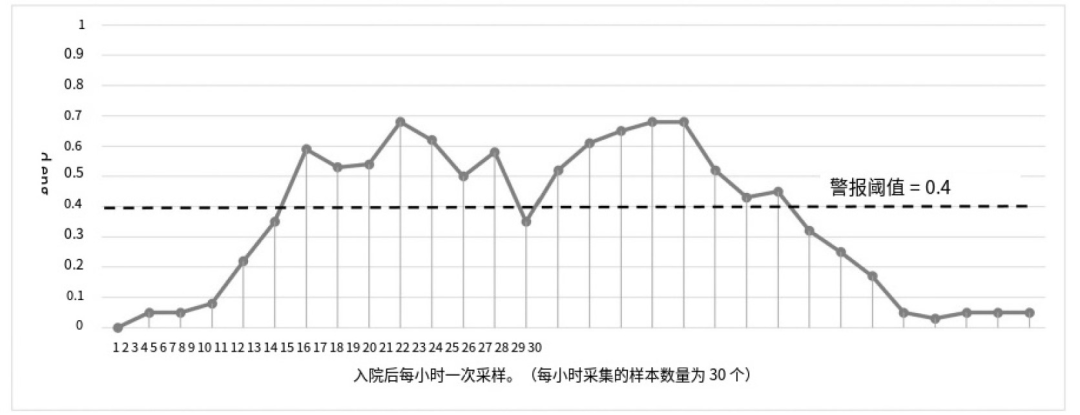
图1.图表展示了单次患者入院期间模型输出样本(0到1之间的十进制数值),按入院后每小时报告一次(每小时样本)。警报阈值代表模型输出,当输出超过该阈值时,将触发脓毒症阳性警报。
拟议的新颖性评估
图3展示了所提出的评估图表如何通过样本水平敏感性作为共同的横轴相互关联。这使得能够直观呈现模型警报阈值在整个范围内的变化对模型有效性(图B,敏感性)、效率(图B,阳性预测值及被提醒患者的比例)以及实用性(图C,首次警报至临床事件的中位小时数;图D,首次警报在临床事件前到达的比例)的影响。通过在四个图表上绘制一条垂直线,可以确定每个EEU因素下模型性能的全部可能性,以及各因素之间所需的权衡关系。在脓毒症预测案例研究中,临床专家委员会使用了这种集成可视化展示来:a) 确定该模型在敏感度为80%(入院水平)的预警阈值下不适合用于临床实践,因为大多数首次预警会在临床医生已怀疑脓毒症时到达(体现在血培养或抗生素的开具上),或与现有Q-ADDS系统触发患者评估的时间重合(见图4中的阈值A和表4);b) 选择一个能够最优平衡三项EEU因素的警报阈值,即临床可接受的敏感性、阳性预测值/所需通知人数以及警报提前时间(见图4,阈值B)。因此,在本案例研究中,临床委员会通过协商一致认为0.12的警报阈值最为理想(见表4第3列)。
表3。训练集和测试集的患者及入院特征
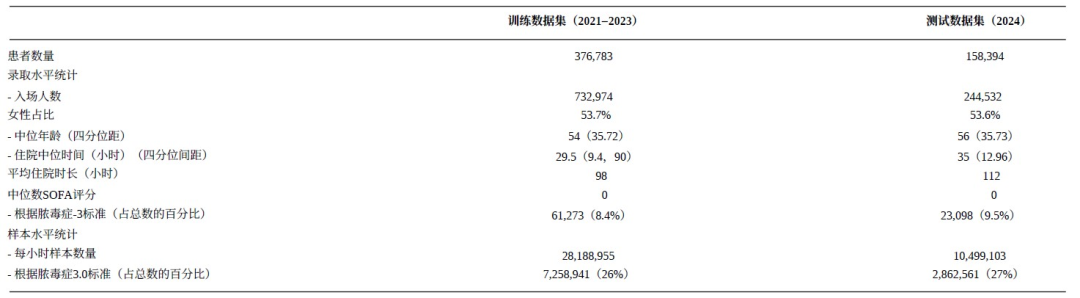
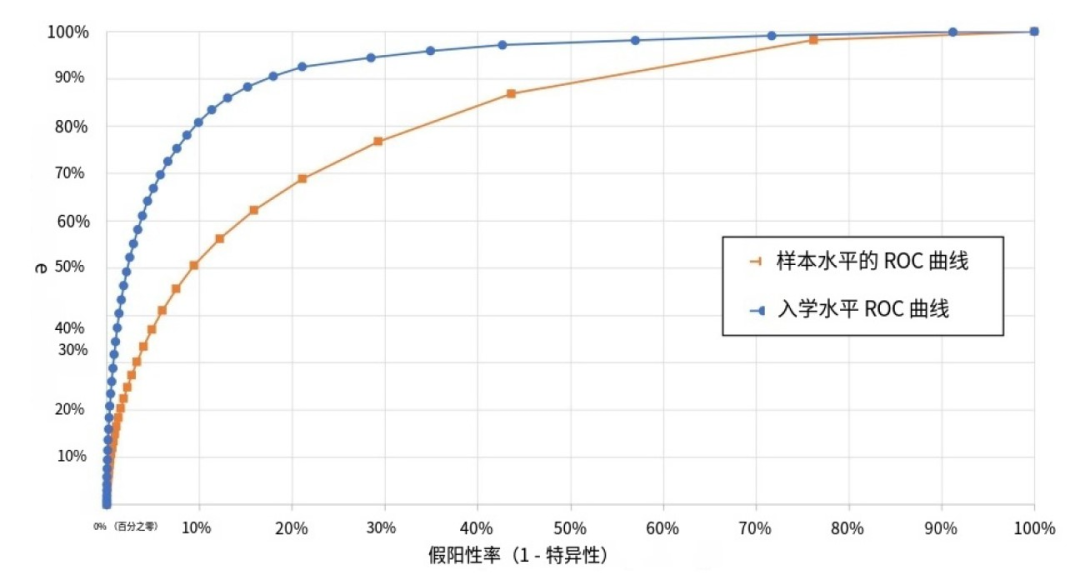
图2。在样本级别测试数据集(橙色线条,方块标记)和入院级别测试数据集(蓝色线条,圆点标记)上评估模型的受试者工作特征曲线。ROC = 受试者工作特征曲线。
表4。脓毒症预测模型在测试数据集上的评估结果。
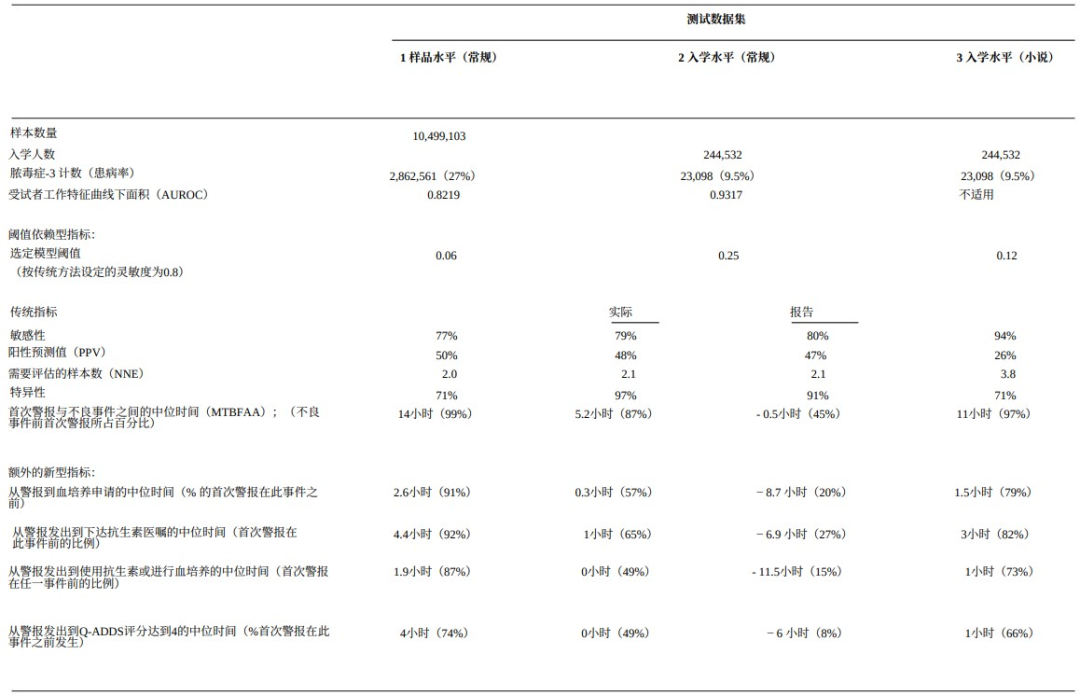
传统的评估指标在样本层面(第1列)和入院层面的Test-adm数据集(第2列)上均进行了展示,所采用的警报阈值能使模型敏感度尽可能接近80%。请注意,入院层面 的传统指标记录的是:若使用每次入院的最大模型输出值构成的数据集,则“报告”的结果;或若采用首次超过阈值的评分来汇总数据集(即与新评估方法相同的方 式),则为“实际”结果。此外,还展示了通过新评估方法确定的警报阈值设置下的传统指标(第3列)。位于表格底部的新评估指标,分别针对传统警报阈值设置以 及通过新评估方法确定的警报阈值生成。 NNE 是 PPV 的倒数,表示需要评估多少名发出警报的患者才能发现一名真正患有脓毒症的患者,可反映潜在的警报疲劳情况。 不良事件:符合脓毒症-3标准。
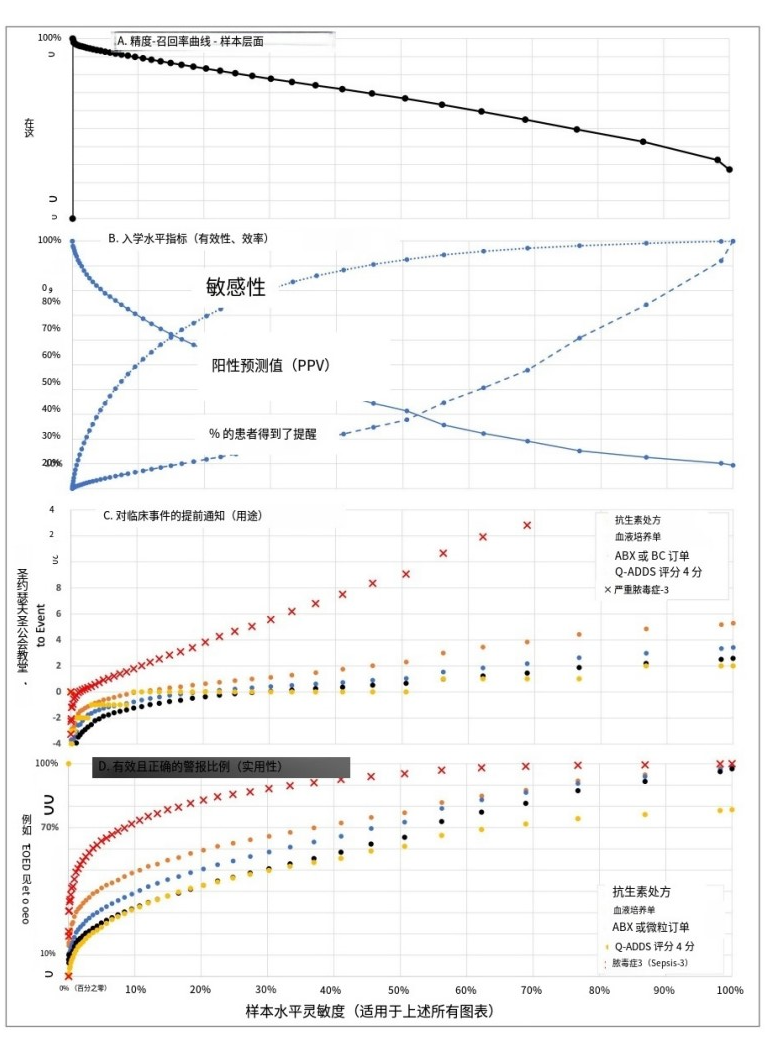
图3。新型标准化模型评估图集,所有图表均采用相同的横轴(样本水平敏感性)。从上至下:(A) 样本水平的精确率-召回率曲线;(B) 入院水平敏感性(蓝色虚线,圆点标记)、阳性预测值(蓝色线,圆点标记)以及发出警报的患者比例(蓝色点划线,圆点标记);(C) 从首次警报到以下事件的中位小时数:符合脓毒症-3标准(红色十字)、血培养申请(蓝色圆点)、抗生素处方(橙色圆点)、血培养或抗生素处方(黑色圆点),以及Q-ADDS系统评分达到4分(需医生审查患者)(黄色圆点);(D) 首次警报在(C中相临床事件发生前的比例,使用与(C)相同的颜色标记。缩写:Q-ADDS = 昆士兰成人病情恶化检测评分。
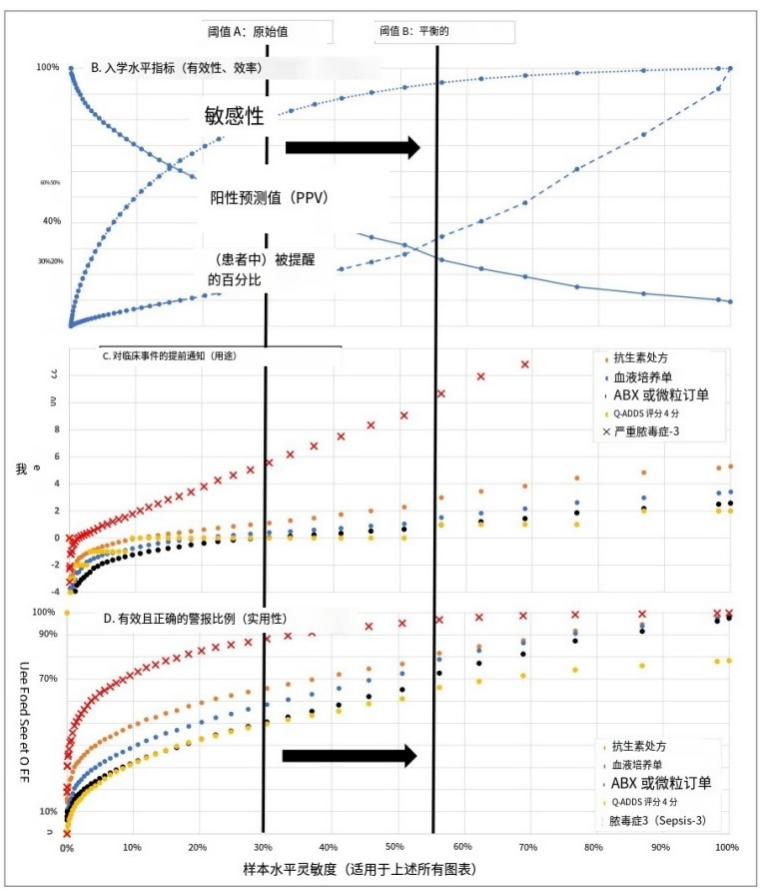
图4。图3中的相同图表B、C和D,但此次展示了两种模型警报阈值的选择(粗黑竖线)。原始阈值选择(阈值A)基于传统方法下入院水平的敏感度为0.8。平衡阈值 选择(阈值B)显示了如何在有效性(图B)、效率(图B)和实用性(图C和D)之间进行权衡,以选择一个能在抗生素或血培养医嘱下达之前、以及在达到需要临床 医生审核的Q-ADDS 4级之前,就发出首次警报的阈值。
六、讨论
评估持续监测患者数据的人工智能预测模型的一个关键目标, 是确定性能最优的模型及其预警阈值,以在临床实践中实现 有效性、效率和实用性的最佳平衡。使用传统的判别性指标 (如AUROC和 AUPRC)来选择模型,并采用决策曲线 分析(DCA)设定预警阈值的方法,并未实现这一目标, 因为这些方法最初设计用于评估一次性使用的风险评估工具, 而未将预警时间与临床事件发生的时间关系作为变量考虑, 尽管这一点在评估任何基于模型的工具临床实用性时至关重 要。当临床医生已知晓所预测事件的发生后才收到预警,这种延迟会分散注意力、浪费时间、 加剧警报疲劳,并削弱对工具的信任度和采纳。我们 提出的方法论是首个标准化且易于可视化的方案,可帮助临 床医生和医疗机构系统性地评估预测模型在全部预警阈值范 围内平衡这三项E-E-U因素的能力。
现有方法在评估基于人工智能的预测模型方面的局限性
目前使用患者监测数据评估基于人工智能的预测模型的传统 方法缺乏标准化,常常存在模糊、无效或不足的问题,难以 帮助临床医生准确评估这些模型。我们发现,使用不同层次 的评估数据集(样本级和住院级)是常见做法,但容易引起 混淆并具有误导性。样本级数据集包含每次住院期间生成的 所有预测结果(例如,在我们的案例研究中包括所有每小时 的预测),而住院级数据集仅包含一个选定的样本,通常是 模型输出概率最高的那个样本。样本级数据集往往偏向于病 情较重且住院时间较长的患者(即拥有更多小时级样本), 这解释了为何在我们的案例研究中,样本级测试数据集中脓 毒症-3的患病率比住院级数据集高出2.8倍。另一方面,采用 基于最高脓毒症概率选择单一样本的住院级评估数据集(在 本研究中其AUROC比样本级数据集高13.4%)具有误导性, 不应被采用。原因在于,所有判别性指标(如AUROC)都 是在0到1之间的每个警报阈值下测量真阳性率和假阳性率的。 而通过为每次住院选择单一样本,住院级数据集会遗漏所有 其他阈值下的样本,因此仅提供了模型输出中一小部分结果 的真阳性与假阳性值,在本研究中仅为全部样本的2%。此 外,如果为每次住院选择模型输出概率最高的样本,则住院 级数据集将偏向于较高的警报阈值(即预测事件发生的可能 性更高),从而解释了更高的AUROC值。由于这些原因,从单一住院级数据集中计算出的传统指标(见表4第3列及 “报告”子列)是无效的,因为与样本级数据集的指标相比, 它们无法反映模型在真实临床环境中部署后的实际表现。
传统指标还存在其他严重局限性。首先,在实施基 于人工智能的监测模型时,大多数医院会采用警报抑制 策略以减少警报疲劳,通常在首次发出警报后即进行抑 制,而多数情况下首次警报已引发临床医生的响应,这相当于在本研究中移除了98%的所有警报。因此, 基于所有警报来评估模型与实际使用方式不符。其次, 了解模型在样本层面而非住院层面的阳性预测值 (PPV)、特异性和敏感性,也违背了临床医生对这些 指标的理解和应用习惯。在模型选择方面,大多数临床 医生更关心的是模型能及时识别出多少比例的脓毒症事 件(敏感性)以及额外误报了多少患者(反映在PPV和 NNE中)。敏感性与PPV在样本层面和住院层面的评估 之间关系不同。例如,在本研究中,样本层面的PPV为 50%,而住院层面仅为15%(即每2名被警报的患者中有1 名正确,每7名中有1名正确)。我们得出结论,直接使 用样本级数据集来选择最佳模型或警报阈值会具有误导 性,且很可能并非最优。
所提出的新颖标准化模型评估方法的优势 我们提出的预测模型评估合成与呈现方法,使临床医生 及其他决策者能够透明地评估模型在所有预警阈值下的 EEU(预期效果)因素。该方法通过三种创新方式克服 了现有传统方法的局限性:(i)以样本级数据集为基础 进行模型评估,同时为每个阈值生成入院级别的指标, 从而克服了前述偏差及其他限制,更真实地反映模型在 所有阈值下的实际应用表现;(ii)测量预警时间相对于 特定临床操作的时间关系,而不仅仅是针对预测事件本 身(即是否符合脓毒症-3标准),并确定首次预警在每 项操作前到达的比例,从而更现实地表明预警能为临床 医生提供多大程度和频率的提前警示,有助于更准确地 评估模型的实用性;(iii)以可视化方式呈现模型评估 结果,使临床医生能够直观观察各EEU因素之间的相互 作用,并综合考虑不同情况。
所提出的新颖标准化模型评估方法的优势
我们提出的预测模型评估合成与呈现方法,使临床医生及其他决策者能够透明地评估模型在所有预警阈值下的EEU(预期效果)因素。该方法通过三种创新方式克服了现有传统方法的局限性:(i)以样本级数据集为基础进行模型评估,同时为每个阈值生成入院级别的指标,从而克服了前述偏差及其他限制,更真实地反映模型在所有阈值下的实际应用表现;(ii)测量预警时间相对于特定临床操作的时间关系,而不仅仅是针对预测事件本身(即是否符合脓毒症-3标准),并确定首次预警在每项操作前到达的比例,从而更现实地表明预警能为临床医生提供多大程度和频率的提前警示,有助于更准确地评估模型的实用性;(iii)以可视化方式呈现模型评估结果,使临床医生能够直观观察各EEU因素之间的相互作用,并综合考虑不同情况。这些因素相互作用方式不同的场景(见图4),可通过为 每个指标使用相同的、等比例缩放的x轴将图表垂直对齐, 然后在x轴任意位置画一条垂线,即可轻松理解。 在我们的脓毒症案例研究中,这种新颖的评估方法使 得模型阈值的选择过程更加透明,所选阈值与传统指标选 择的结果大不相同。临床医生认为,该AI工具最具吸引力 的因素是其实际效用,即能够比临床直觉或现有早期预警 系统更早地识别并治疗病情进展中的脓毒症患者。因此, 我们牺牲了模型效率(即减少误报的能力)(见图4), 直到模型平均能比临床医生自身怀疑脓毒症并采取应对措 施提前至少1小时发出预警。这一目标对应的预警阈值为0. 12,而传统评估方法得出的阈值则为0.25,虽然效率更高 (即阳性预测值更高),但大多数警报并未为临床医生提 供任何提前预警。
对研究与实践的启示
根据我们的研究结果,我们认为传统的评估指标(如 AUROC、AUPRC、Matthews相关系数、模型校准和决策曲线)在评估人工智能预测模型性能或为真实世界持续 患者监测选择最佳预警阈值方面存在不足。尽管这与当前 的实践相悖,但传统指标并未将预警时机与临床医生的直 觉和实际操作纳入计算,而这一因素恰恰是影响工具采纳 率和医疗结局的关键实用性要素。在本研究中,一个表现 优异(高AUROC)的模型并未被视为具有临床实用性, 许多其他已部署的模型可能也存在类似局限性,这或许部 分解释了为何已有报道显示实施的预测工具对医疗结局的 影响参差不齐甚至呈负面趋势。 我们建议模型开发者在与临床用户合作时,采用我们 提出的模型评估方法。我们还建议,人工智能预测模型的研究报告指南(如 TRIPOD-AI)应要求作者明确说明在模型评估中使用样本 或入院水平数据集的方法和原因,以降低报告误导性或无效结果的风险。
七、结论
尽管许多基于人工智能的监控预测工具已被投入使用,但 改善护理效果的证据仍然有限。这在一定程度上可能归因于所实施模型性能和实用性不佳,导致临床医生采纳率较低。传统的模型性能评估方法存在局限性,且根据所使用的评估数据集类型不同,可能会产生偏差并具有误导性。一种新型的EEU评估方法克服了这些局限,为决策者和临床医生提供了一种标准化方式,以评估模型是否适用于其临床环境,并在前瞻性评估和试点试验之前选择最佳的预警阈值。
话险危夷·述评
该论文针对住院患者监测中AI预测模型评估的标准化问题,以脓毒症预测为例,提出了一种平衡有效性、效率与实用性(EEU)的新方法。研究基于7家医院977,506例住院数据,系统比较了传统指标(AUROC、敏感性、PPV、特异性)与新图形化评估框架的差异。其核心贡献在于指出传统指标忽视预警时机与临床事件的时间关系,且样本级与入院级评估数据集混用易导致偏差和误导。新方法通过四幅垂直排列图表,整合不同阈值下的预测准确性、预警负担及预警提前时间,使决策者能直观权衡EEU因素并选择最优警报阈值。案例中,临床委员会最终选定0.12阈值,而非传统指标推荐的0.25,体现了实用性优先的临床逻辑。该研究的突出价值在于将“预警是否早于临床怀疑”作为效用核心,弥补了AUROC等指标无法反映时机信息的缺陷,也为TRIPOD-AI等报告指南提供了改进方向。然而,该方法依赖临床专家共识确定阈值,可能引入主观性;且单中心数据虽具代表性,但外部泛化仍需验证。总体而言,这项研究为AI预测模型的临床转化提供了更贴近实际工作流的评估范式,对减少警报疲劳、提升医生采纳率具有重要实践意义。
文献出处:van der Vegt, AH, Campbell, VK, Webb, R, et al. A novel, standardised approach to balancing effectiveness, efficiency and utility of surveillance AI prediction models for hospitalised patients using sepsis prediction as an exemplar. J AM MED INFORM ASSN. 2026; 33 (2): 304-315. doi: 10.1093/jamia/ocaf192