人工智能模型为医疗领域的发展带来全新机遇,但由于医疗场景数据类型繁杂、任务谱系广泛,疾病的、治疗与病情监测也依赖多种不同数据源以及不同医学专科之间信息的交叉整合,因此也产生并使用规模空前、类型多样的数据。大型多模态模型在识别复杂数据模式、生成文本和处理视觉信息方面展现出显著能力,有望重塑AI辅助医疗工作并挖掘新见解;但通用多模态模型欠缺精细的医学认知,无法稳健完成对医疗数据的可靠解读与逻辑推理。
近日,谷歌团队基于Gemma3架构开发了MedGemma,这是一套医学视觉-语言基础模型。MedGemma在图像、文本以及多个医学影像领域展现出先进的医学理解与推理能力,性能超过同等规模的生成模型,同时保持了Gemma基础模型的通用能力。对于分布外任务,MedGemma在医学影像问答任务上相较基础模型提升2.6%-10%,在胸部X光片病灶分类任务上提升15.5%-18.1%,在智能体评估任务上提升10.8%。此外,研究团队还推出了MedSigLIP,这是一种基于SigLIP的医学调优视觉编码器,可为MedGemma提供视觉理解能力,并且作为独立编码器,其性能可媲美甚至优于多款专用医学影像编码器。总之,MedGemma系列模型具备强大的医学图文处理能力,有望加速医学研究以及下游应用的开发。相关内容发表在Nature Medicine。
MedGemma基于Gemma 3构建,包含三种模型变体,可适配各类实际下游应用场景。其中,两个多模态模型MedGemma 4B与MedGemma 27B,参数量分别为40亿和270亿,支持文本、图像或图文联合输入;以及面向文本输入优化的MedGemma 27B Text。
视觉端配套MedSigLIP编码器,参数规模4亿,由SigLIP400M经过数百万组医学图像-文本对数据微调得到,覆盖放射、病理、皮肤和眼科等模态。其既是MedGemma的图像理解核心,也可以独立作为医学图像编码器使用,支持零样本图像分类与图像检索任务,并表现出与专用医学编码器相当或更优的性能。
MedGemma保留Gemma3原有通用语言能力,仅依靠这一套基础模型就能够微调适配多种医学AI研发场景。该模型全部开源,现有指标仅为基础性能,研究团队同时提供多个医学场景的微调示例,方便全球研究者针对不同临床需求继续完善模型。
研究团队在多项医其学文本和医学影像基准测试上,从医学文本问答、医学图像分类、开放临床推理、医学视觉问答、胸部X光(CXR)报告生成、智能体代理行为六大维度对MedGemma开展性能评估,测试集包含分布内基准与分布外(OOD)基准数据集,包括MedQA、MedMCQA、PubMedQA、MMLU Med、AfriMed-QA、EHRQA。结果显示,总体而言,MedGemma在多项任务上的准确率超过或持平于规模更大的非开放模型和任务专用模型。
在医学问答任务(仅文本)中,MedGemma在多个基准测试中的表现均优于Gemma 3基础模型,并在部分任务上接近更大规模的模型。该模型在MedQA上达到86.2分,发布时为开源模型中的领先水平,仅次于6710亿参数的DeepSeek-R1(91.0),明显高于OpenBioLLM70B(78.2)。在MedHallu测试既有的“困难集”上,MedGemma 4B归一化得分为0.50,而Gemma 3 4B仅为0.09,可以显著区分正误医学答案。
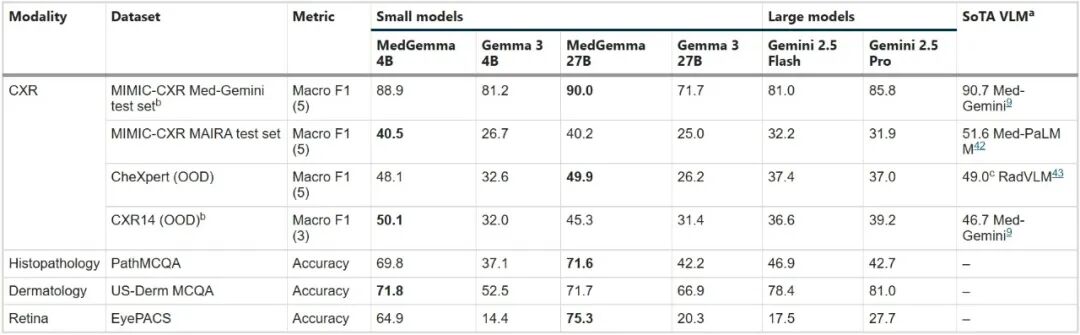
医学影像解读是多模态MedGemma模型的核心亮点。医学图像零样本分类任务覆盖胸片、病理、皮肤、眼底多模态影像。结果显示,MedGemma不仅显著优于Gemma 3基础模型,还优于体量更大的API闭源模型。如在CheXpert、CXR14胸片数据集以及EyePACS眼底数据集中,MedGemma 4B的Macro F1分别达88、50.1和64.9,显著高于Gemma 3 4B。
表1. 影像学分类准确性
在SLAKE和VQA-RAD等医学视觉问答任务中,MedGemma同样优于Gemma 3,并与更大API模型表现相近。开放医学问答任务由执业医师人工评估模型输出,相较Gemma 3 4B,MedGemma 4B事实错误回复占比下降约17%;该模型还可完成开放式临床推理任务,够有效提炼病例关键信息,并给出对应的临床处置建议。
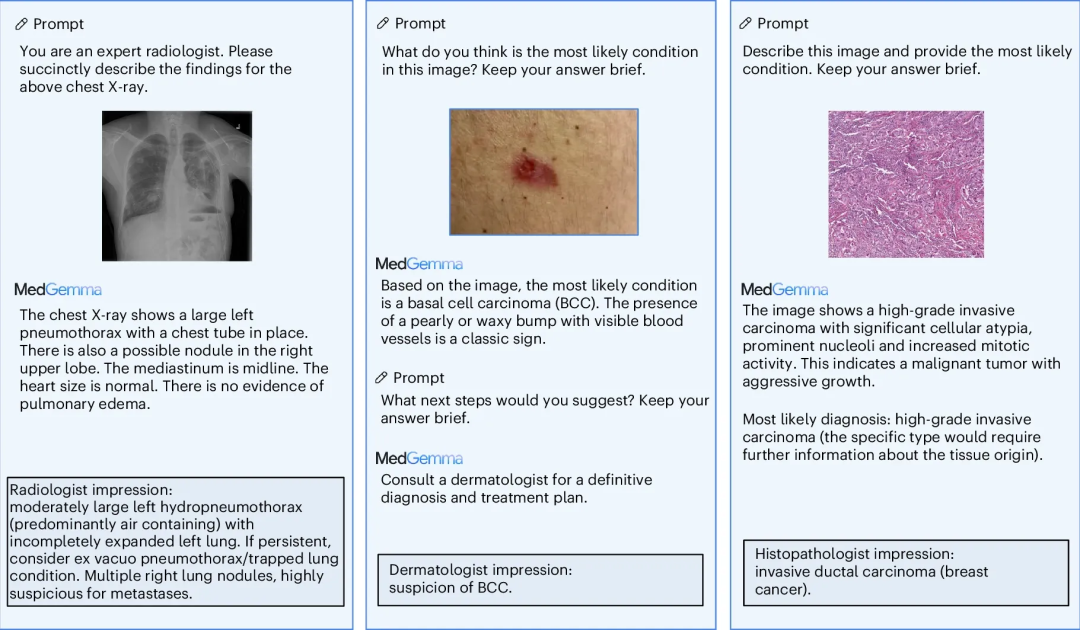
图2. MedGemma 4B开放式多模态问答示例
针对CXR报告生成任务,MedGemma 4B预训练模型RadGraph F1为29.5,经强化学习微调后提升至30.3,在该指标和数据集上达到领先水平。专家人工评估显示,81%的生成报告被认为可能带来与原始报告相同或更优的临床决策,优于Med Gemini的73%。第三方ReXrank评估中,MedGemma 4B在ReXGradient和IU-Xray数据集上取得最高GREEN分数,并在ReXVQA医学视觉问答评测中位列中进入前三。
研究团队并未针对CXR解剖定位任务做专项优化,但MedGemma 27B的训练数据中包含解剖边界框标注,为此团队在Chest ImaGenome测试集上使用交并比(IoU)评估了模型性能。MedGemma 27B的IoU值为 0.16,基础Gemma 3 27B 为 0.08。
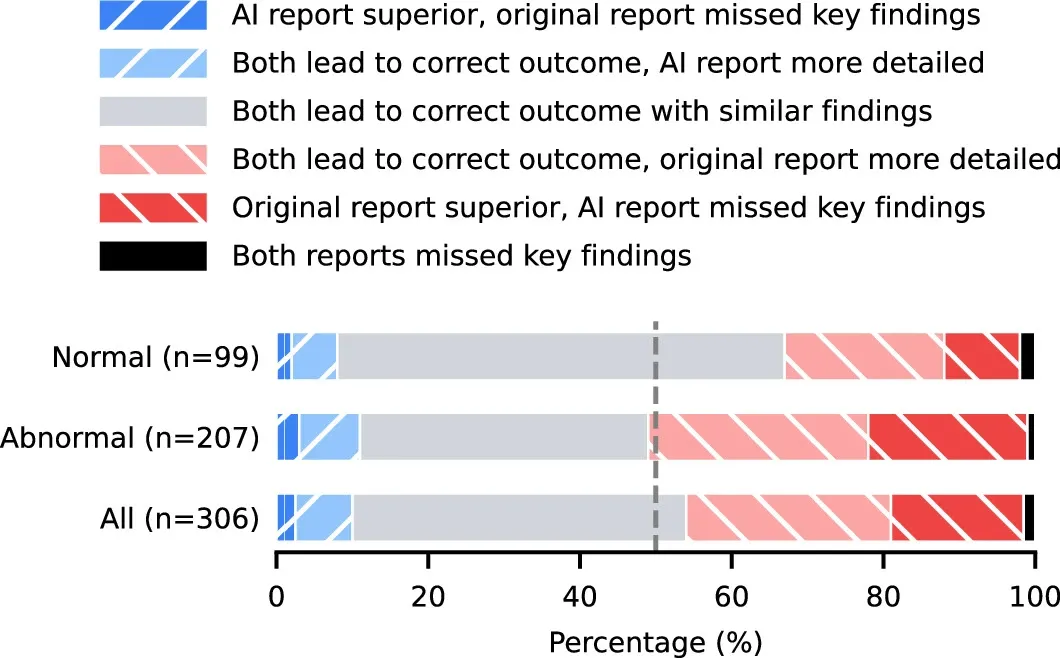
图3. CXR报告的人工评估
在AgentClinic智能体评测中,MedGemma 27B在大部分测试集上超过人类医生表现,并在两个数据集上接近更大模型;但4B模型在该智能体框架中表现不佳,提示小模型指令遵循能力仍有限。通用基准测试表明,经过医学领域适配后,MedGemma在通用基准MMLU Pro、MMMU上性能仅有小幅下降,保留通用大模型基础能力,适配医疗场景中通用交互需求。
最后,研究使用三个未参与MedGemma训练的数据集,并分别以MedGemma 4B或Gemma 3 4B作为基础模型进行微调实验。结果显示,MedGemma 4B性能优于Gemma 3 4B,尤其在仅使用10%训练数据时优势更明显。在部分分类任务中,Gemma 3会出现模型崩溃,只会预测样本占比最高的类别,而MedGemma可避免该现象。此外,研究团队还对MedGemma进行了强化学习微调。微调MedGemma 4B在CXR报告生成任务上取得 RadGraph F1 30.3,达到该指标和数据集的最先进水平;在电子病历问答任务上,微调MedGemma 27B Text也带来性能提升,在跨多条病历记录推理类问题收益最为明显。
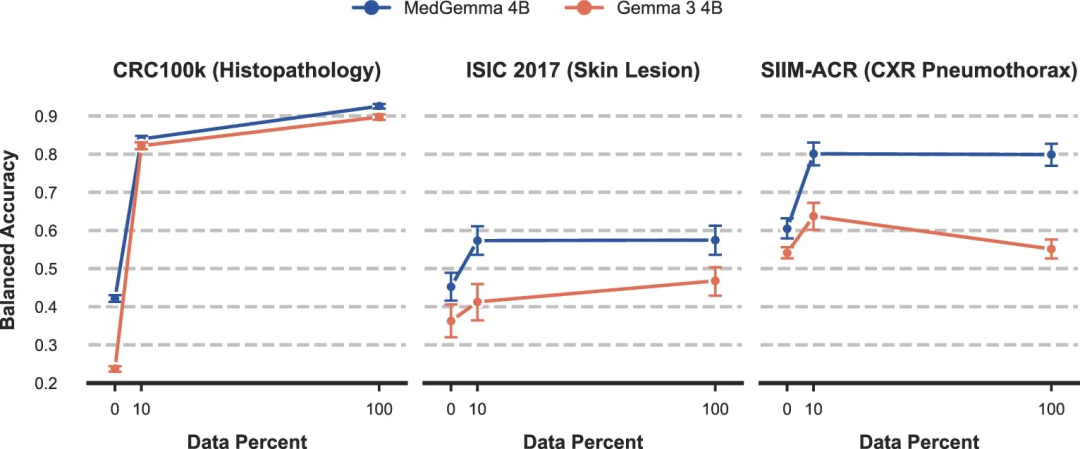
图4. MedGemma 4B和Gemma 3 4B的微调性能
MedGemma与MedSigLIP的开源发布,为医学图像和文本任务提供了统一、可微调、可本地部署的基础模型选择,兼顾数据与模型主权、计算效率和医学多模态能力。其潜在应用包括医学图像检索、研究队列构建、临床试验患者筛选、临床报告辅助撰写等。同时研究指出,模型错误、训练数据分布偏差和真实世界安全性仍需持续验证;在部分专用任务上,专用模型仍可能更优。
参考文献:
https://www.nature.com/articles/s41591-026-04626-w